(三十三)运行回归与图形分类
1. 先检查数据与目录
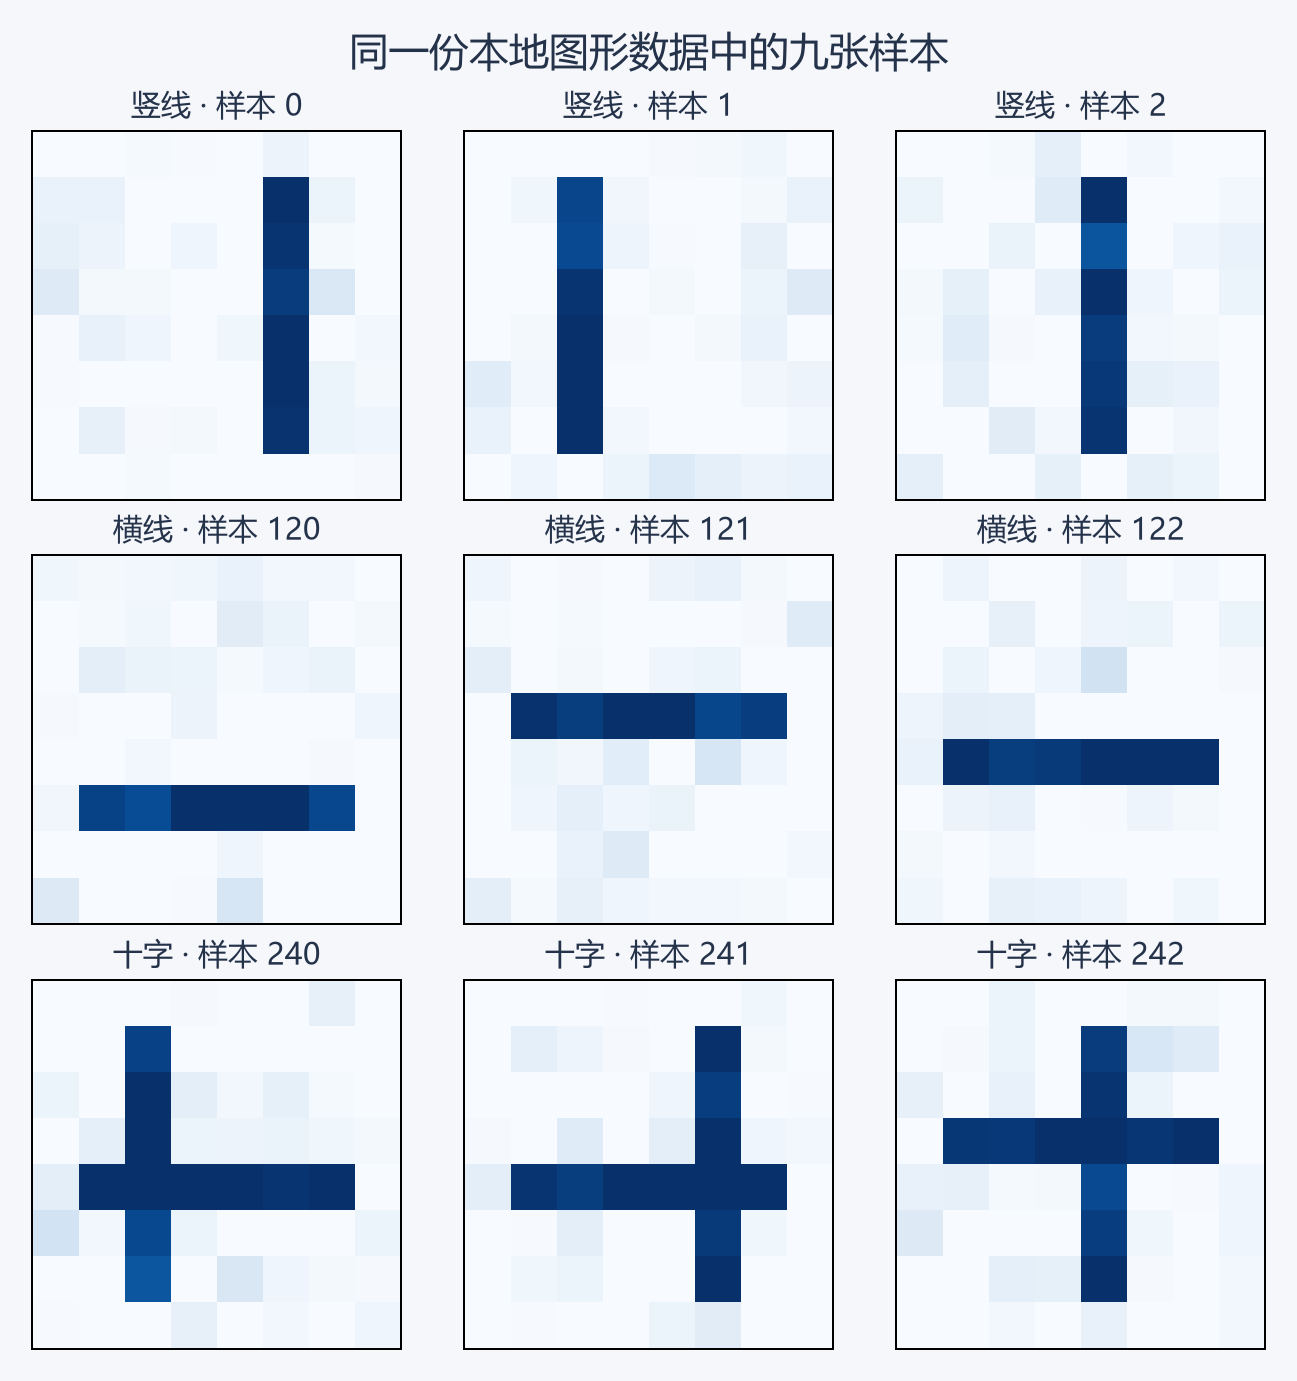
data/reading.csv 有 240 条自拟阅读记录,使用“2×分钟数+3×次数+5 加小幅扰动”生成页数。data/symbols.npz 有 360 张自绘图,每类 120 张,每张随机改变线条位置并加入轻微像素扰动。原文件和生成脚本一起提供。
先看几张实际输入:同一类别的线条位置不同,较浅的像素来自扰动。可以运行 preview_data.py 重画,核对数组中保存的内容。
# 在 training_project 中运行两项离线训练。
uv run reading-train train --task regression --data data/reading.csv --output runs/regression --epochs 30
uv run reading-train train --task images --data data/symbols.npz --output runs/images --epochs 18
2. 选定后评估与预测
# 测试集在训练和验证选择完成后读取。
uv run reading-train evaluate --checkpoint runs/regression/best.pt --data data/reading.csv
uv run reading-train evaluate --checkpoint runs/images/best.pt --data data/symbols.npz
# 输入新特征,或读取一张配套图,查看保存模型的预测。
uv run reading-train predict --checkpoint runs/regression/best.pt --minutes 35 --sessions 3
uv run reading-train predict --checkpoint runs/images/best.pt --image data/one_symbol.npy
这次 CPU 运行得到以下结果,完整数值见 核验记录:
| 项目 | 验证选中轮数 | 测试结果 | 对照基线 |
|---|---|---|---|
| 阅读页数回归 | 24 | 48 条记录,RMSE 约 0.337 页 |
始终取训练均值,RMSE 约 27.336 页 |
| 三类自绘图形 | 12 | 72 张图,72 张正确 | 固定猜一类,准确率为 1/3 |
这份自绘图的类别结构很明确,可以用它逐项检查输入、训练和保存过程。继续处理手写字、照片等任务时,再准备相应数据、类别和评价方式,按同一流程比较基线与错误样本。